Личный блог Павла Злобина / AI-видео на практике
Моё лицо.
Мой сценарий.
Другая реальность.
Из обычной записи — в новую сцену. Или из фотографии и текста — в говорящее видео через Google. Показываю, как создаю видео для своего блога: рабочие способы, реальные расходы и тесты, которые не получились.
4 рабочих подходатри с записью + Google по тексту
9 примеровс результатами и оговорками
1 открытая задачаточный клон голоса без съёмки
Как читать эту страницу. Все примеры — AI-обработанные сцены с моим участием, не документальная съёмка этих локаций. Цены — ориентировочная себестоимость генерации в сервисе, не стоимость производства под ключ. Тесты показываю вместе с ограничениями.
СРАЗУ О РЕЗУЛЬТАТАХ
Что получилось, а что — нет
Оцениваем конкретный ролик под его задачу, а не модель целиком. Статус и причина также указаны прямо над каждым видео.
«Получилось» не означает идеальный lipsync во всех сценах. Google уже дал удачные примеры аватара с новым русским текстом. Точный собственный клон голоса в этом процессе ещё не проверен.
Говорящая голова с моим голосом
Kling 3.0 Motion Control · std
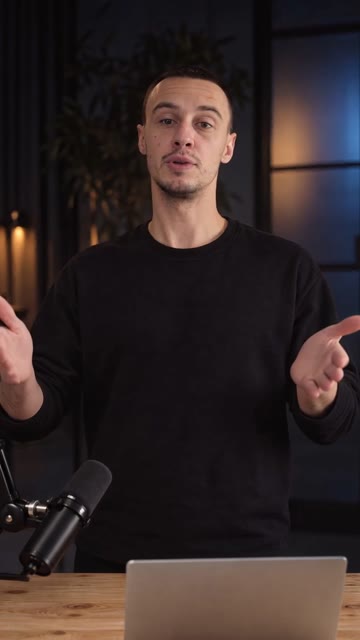
Я записываю речь и жесты на телефон. Затем меняю образ и окружение: например, вместо обычной комнаты оказываюсь в студии. В финале остаётся моя исходная аудиозапись.
≈41 ₽ за короткий тест / 10 кредитов
Как делаем
- Записываю вертикальное видео с окончательным текстом.
- Готовлю изображение себя в нужной одежде и локации.
- Передаю видео и изображение в Kling Motion Control.
- Возвращаю оригинальную звуковую дорожку без ускорения и проверяю лицо, руки и губы.
Для чего: экспертные короткие видео, объяснения, выступления в новом интерьере.
Новый текст из старой записи так не получить: другую речь нужно записать заново. Фон в наших тестах преимущественно статичный. Точность губ и сходство проверяем в каждом результате.
С ОГРАНИЧЕНИЯМИОбраз и исходный голос перенесены. Полное сходство и lipsync ещё не утверждены; есть пересечение руки и микрофона.
Ещё пример: офис до и после щелчка
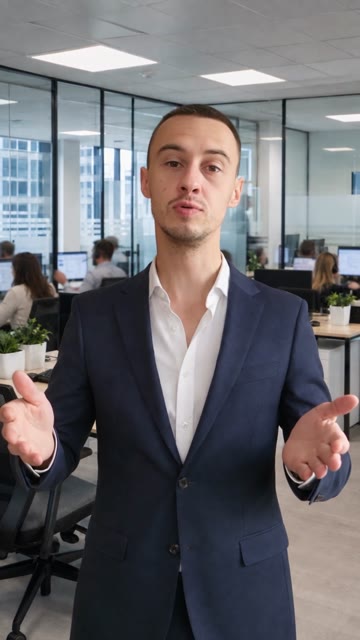
Два отдельных прогона Kling и склейка. Люди исчезают, но до перехода сотрудники на фоне статичны. На стыке возможен небольшой скачок геометрии. Расход за два прогона — 20 кредитов, около 83 ₽.
С ОГРАНИЧЕНИЯМИСклейка занятого и пустого офиса получилась, но сотрудники до щелчка статичны. На переходе возможен скачок геометрии.
Смешные ролики с подписью
Genjutsu · Motion Transfer или Object Swap
Беру видеообразец с нужным действием, добавляю свой образ и меняю персонажа, одежду или окружение. Комическую подпись накладываю отдельно при монтаже — так текст остаётся точным и читаемым.
≈145 ₽ за 5 сек / 35 кредитов*
Как делаем
- Выбираю видео с правом на переработку и подходящим движением.
- Готовлю изображение своего персонажа и описание изменений.
- Выбираю один режим: Motion Transfer для переноса действий или Object Swap для замены элементов.
- Проверяю результат и добавляю подпись, звук или музыку.
Для чего: мемы, визуальные шутки, короткие реакции и необычные образы.
Готового мема с подписью пока нет. Рядом — мой технический тест переноса движения, а не законченный юмористический ролик. Чужой видеообразец сам по себе не даёт мой голос.
НЕУДАЧНО ДЛЯ ДИНАМИЧНОГО ФОНАДвижение человека перенесено, но фон замер. Для цели «живой офис» результат отклонён; это не готовый мем.
Динамичная сцена с моим голосом
Genjutsu · Object Swap
Записываю себя в движении и сразу произношу текст, подходящий будущей сцене. Genjutsu меняет окружение по референсам и промпту. Речь в готовом видео — из моей записи.
≈145 ₽ за короткий тест / 35 кредитов
Как делаем
- Снимаю нужные действия, жесты и речь.
- Готовлю референсы целевого окружения.
- В Object Swap описываю замену фона, движение и момент перехода.
- Сохраняю исходный звук и проверяю действия, фон и синхронизацию.
Получившийся пример: на заднем плане работает офис, дальний сотрудник движется. На жесте люди исчезают, столы и компьютеры остаются.
Переход в этом тесте выглядит немного раньше нужного щелчка. Движение одного сотрудника заметно; сложные действия остальных не подтверждены. Это результат конкретного теста, не гарантия любой динамичной сцены.
ПОЛУЧИЛОСЬ · ОСНОВНОЙ ЭФФЕКТЕсть движение сотрудника, затем люди исчезают, мебель остаётся. Этот вариант принят как пример; переход немного раньше щелчка.
Следующая идея: канат над пропастью
Я снимаю балансирование и осторожные шаги на безопасном ровном полу. Нейросеть должна добавить горы, пропасть и канат. Для этого нужны полный рост, видимые стопы и реальная имитация шагов.
Этот сценарий ещё не протестирован. Контакт ног с канатом — отдельная сложность: обычной замены фона может не хватить. Снимать настоящий опасный трюк не нужно.
Мой аватар и голос — по текстовому сценарию, без видеосъёмки
Цель: задать текст, действия, одежду и локацию, а на выходе получить реалистичное видео со своим лицом и голосом. Например, я захожу в ресторан, сажусь, разговариваю с человеком или иду по улице — без предварительной записи этого выступления на камеру.
Все требования вместе, включая именно мой клонированный голос, пока не закрыты. Аватар с новым русским текстом и обычным мужским голосом уже получился в Google — см. вариант 5. Ниже — мои экспериментальные результаты, которые не закрыли все требования одновременно.
Что должно подаваться на вход
Мои фотографии или согласованный образ + образец моего голоса / клон + точный текст реплик + описание действий, одежды и локации. Фотографии и образец голоса нужны для сходства; исходное видео с заранее произнесёнными репликами и движениями — не нужно.
Что должно получаться
- Узнаваемое лицо без искажений при движении и смене ракурса.
- Мой голос и точный русский текст, без пропусков, сокращений и ошибок произношения.
- Естественная мимика и губы, синхронные каждой реплике.
- Заданные действия, стабильные одежда и локация, правдоподобное взаимодействие с людьми и предметами.
Главное отличие от первых трёх пунктов: движения и речь здесь нужно создать по сценарию, а не перенести из уже снятого видео. Просто подложить хороший голос под сгенерированное лицо недостаточно — артикуляция от этого не исправляется.
Тест 1. Ресторан: движение есть, полного решения нет
Seedance 2.5, 10 секунд. В результате я подхожу к столу и сажусь; готовой видеозаписи такого действия на входе не было.
Как именно сделали ресторанное видео
- Сначала через ElevenLabs внутри Higgsfield создали готовую аудиозапись всей нужной реплики моим клоном. Мне не требовалось заново начитывать этот текст самому.
- Подготовили картинку меня в ресторане — она задавала лицо, одежду и окружение.
- Передали в Seedance 2.5 картинку, эту аудиозапись и промпт с действиями: идти к столу, сесть и говорить; на фоне движутся посетители и официанты.
- Модель создала видео с движениями тела, лица и губ, опираясь на аудио. Это не простая подклейка звука: Seedance могла переработать и саму речь.
Важно: в этом ресторанном тесте аудио задавало и голос, и произносимые слова. Это не подтверждённый пример того, как модель берёт только тембр из одной фразы и произносит совсем другой текст из промпта. Точное сохранение голоса, слов и синхронизации не гарантировалось.
Отдельный эксперимент: новый текст по образцу голоса
Другая схема: фото лица + аудио только как образец тембра и манеры + новая реплика текстом + описание сцены → Seedance 2.5 сама генерирует новую речь и видео. Без исходного видео, предварительной озвучки новой реплики и последующей подмены звука.
Для этого способа запущен отдельный короткий тест с офисом и щелчком: 6 секунд, 720p, 9:16, 42 кредита (около 174 ₽ по расчётной базе страницы). Последующие русскоязычные тесты Seedance отклонены: речь не устроила. Рабочим решением этот способ не считаю. Главная проверка — новый русский текст, сходство тембра и синхронная артикуляция, а не просто наличие звука.
Визуально это был перспективный эксперимент. Но наличие аудиореференса не гарантирует сохранение голоса и произнесённого текста. На участке посадки в предыдущей проверке отмечались смягчение геометрии лица и широко открытый рот. Этот файл не считаю подтверждением точного говорящего аватара.
Исторический тест: 65 кредитов ≈269 ₽
Только видеогенерация, без подготовки картинки и клона. Не цена гарантированного результата.
НЕУДАЧНО ДЛЯ ГОВОРЯЩЕГО АВАТАРАДинамика ресторана получилась, но точные голос, лицо и артикуляция одновременно не обеспечены. Визуальный успех не равен готовому аватару.
Тест 2. Клон голоса подставлен — губы всё равно не устраивают
Seedance 2.0, 10 секунд. Сначала подготовили и утвердили озвучку моим клоном. Передали её как аудиореференс, а после генерации заменили модельный звук на исходный утверждённый файл.
Я отклонил результат. Сохранить нужную аудиодорожку удалось, но это не решило задачу естественного говорящего аватара. Эту схему не использую как рабочий способ точного lipsync.
Исторический тест: 45 кредитов ≈186 ₽
Цена видеопопытки; озвучка и подготовка не включены.
НЕУДАЧНЫЙ ТЕСТНужный голос сохранён, но артикуляция и результат аватара не устроили. Этот способ отклонён.
Тест 3. UGC: неразборчивая русская речь и деформация ноутбука
Seedance 2.0, 15 секунд, три сцены в офисе. Здесь тестировали обычную сгенерированную мужскую речь, не мой клон. Лицо и сцены задавали изображениями и текстом.
Результат отклонён: речь неразборчивая, а картинка на экране ноутбука изгибается и не совпадает с плоскостью монитора. Даже красивой раскадровки недостаточно, чтобы получить устойчивый результат в движении.
Исторический тест: 67,5 кредита ≈279 ₽
Только видео, без референсов и повторов.
НЕУДАЧНЫЙ ТЕСТНеразборчивая русская речь и деформированный экран ноутбука. Голос — нативный, не мой клон.
Цена готового решения пока неизвестна. Указанные суммы — расходы отдельных прошлых экспериментов, пересчитанные по той же тарифной базе, что и остальные примеры. Новые модели и способы требуют отдельного короткого теста и согласования бюджета. «Пока не решено» относится к моему проверенному процессу, а не к утверждению, что это невозможно вообще.
Google Vids: мой аватар говорит по тексту и действует в новой сцене
Пока это лучший результат с русской речью среди моих тестов — по моей оценке. Получились два примера: офис со щелчком и ресторан с ходьбой и посадкой. Здесь не нужна заранее снятая запись выступления: речь и действия создаются по изображениям и сценарию.
Как повторить
- Фото лица и образ в локации. Выбираю свою фотографию и готовлю изображение себя в нужной одежде и окружении. Можно использовать уже согласованный образ.
- Точный текст. В промпте отдельно указываю всю реплику на русском: что именно персонаж должен произнести, без сокращений и пересказа.
- Сценарий динамики. Описываю, куда идти, когда сесть или щёлкнуть пальцами, как движется камера и что происходит на фоне.
- Изображение + промпт → Google Vids. Модель создаёт видео вместе с русской речью. Готовую аудиозапись новой фразы и видео с этими движениями не загружаю.
- Проверка и экспорт. Слушаю каждое слово, проверяю лицо, губы, руки, предметы, фон и формат кадра. Сохраняю удачный ролик и его промпт.
Важное отличие от пункта 4: здесь работает новая русская мужская речь, но это пока не подтверждённый клон моего собственного голоса. Успех этих двух примеров не гарантирует одинаковое качество любой следующей сцены.
Пример 1. Офис и щелчок
Задача: говорить в офисе на фоне сотрудников; по щелчку люди исчезают, офис остаётся. Моя оценка результата: «Результат мне понравился, русская речь отлично сделана».
ПОЛУЧИЛОСЬ · ОДОБРЕНО АВТОРОМУспешный тест аватара и новой русской речи по промпту.
Пример 2. Ресторан: иду, сажусь, говорю
Новая сцена: подойти к столику, сесть и продолжить речь, пока на фоне находятся посетители и официант. После этого теста мой вывод: Google лучше всего справился с русским текстом среди опробованных мной вариантов.
ПОЛУЧИЛОСЬ · ОДОБРЕНО АВТОРОМДинамика персонажа и русская речь без предварительной записи выступления.
Цена Google: пока не зафиксирована
Точная модель, версия и лимиты аккаунта не записаны. Тариф Higgsfield $49 за 1000 кредитов к этим роликам не относится. Файлы опубликованы без изменения нативной речи; новые генерации для страницы не запускались.
Сколько стоит генерация
Для Higgsfield считаю по своей подписке: $49 за 1000 кредитов. При расчётном курсе 84,3414 ₽/$ один кредит — около 4,13 ₽. Это распределение стоимости подписки, а не отдельное списание с карты за каждый ролик.
| Один прогон | ≈5 сек | 10 сек | 20 сек |
|---|---|---|---|
| Kling Motion Control std | 10 кр. ≈41 ₽ Фактический тест | 18 кр. ≈74 ₽ Исторический ориентир | 34 кр. ≈141 ₽ Исторический ориентир |
| Genjutsu, 720p* | 35 кр. ≈145 ₽ Проверено для короткого исходника | ≈70 кр. ≈289 ₽ Экстраполяция | ≈140 кр. ≈579 ₽ Экстраполяция |
| Аватар с собственным клоном голоса | Пока не решено. Стоимость готового результата неизвестна; расходы прошлых попыток — в пункте 4. | ||
| Google Vids: фото + текст + динамика | Два успешных теста около 10 сек. Стоимость в рублях и лимит Google пока не зафиксированы. Кредиты Higgsfield здесь не применяются. | ||
* Для Motion Transfer и Object Swap проверен расчёт 35 кредитов на текущем коротком исходнике. Цены 10 и 20 секунд у Genjutsu — плановая экстраполяция, не котировка сервиса. Цены Kling 10/20 секунд — прошлые резервы за задания, завершившиеся ошибкой и возвратом: они не подтверждают качество длинных роликов.
Что не входит в эти цифры
- Работа со сценарием, подготовка исходника, монтаж и проверка качества.
- Новые изображения-референсы: последний проверенный Nano Banana 2 2K — 2 кредита, примерно 8 ₽ за изображение.
- Дополнительные попытки. Каждый платный повтор увеличивает бюджет.
- Комиссии и фактический банковский курс. Стоимость кредитов в другом тарифе может отличаться.
Срез цен: 28.09.2026. Курс для ориентира: 26.09.2026. Перед новым запуском нужно заново проверить цену для конкретного файла и настроек. Это не публичная оферта на услуги.
Что подготовить для форматов 1–3
- Выбрать задачу: говорящая голова, смешной ролик или динамичная сцена.
- Снять короткий исходник 9:16: хороший свет, чистая речь, видимые губы и руки. Для ходьбы — ноги и запас пространства.
- Записать окончательный текст. В этих схемах мы переносим выступление, а не заставляем старую запись говорить новые слова.
- Согласовать образ и бюджет одного теста. Сначала проверяем короткий результат, потом масштабируем.
После генерации смотрим не только на красивый кадр: важны губы, руки, предметы, контакт с окружением и момент перехода. Сохранённая исходная аудиодорожка сама по себе не гарантирует идеальный lipsync.
Есть идея для такого видео?
Пришлите пример движения и опишите, что хотите изменить. Начать лучше с одного короткого теста.
Обсудить идею